Hãy tưởng tượng bạn vừa tuyển được một thiên tài. IQ cao ngất, đọc hết Stack Overflow, viết code nhanh hơn cả team cộng lại. Có điều bạn không đưa cho cậu ấy cái laptop nào, không cấp quyền vào repo, không cho cuốn sổ ghi chép, và sáng nào cậu ấy cũng thức dậy với bộ nhớ trống trơn. Bạn đoán hiệu suất của cậu ấy sẽ ra sao?
Đó chính là hoàn cảnh của một mô hình ngôn ngữ lớn (LLM) trần trụi. Muốn nó thành một AI agent đúng nghĩa, tức là biết gọi công cụ, chạy code, nhớ việc đã làm và tự kiểm tra kết quả, ta phải xây cả một hệ thống bao quanh nó. Hệ thống đó có tên là agent harness. Từ Databricks, Anthropic, OpenAI đến LangChain, năm 2026 này ai cũng đang bàn về nó, vì nhiều khi cùng một model, chỉ đổi harness thôi là kết quả đã khác một trời một vực.
Bài này đi từ khái niệm cơ bản đến những bài học thực chiến, kèm vài cú vấp dở khóc dở cười mà dev nào làm agent cũng từng gặp.
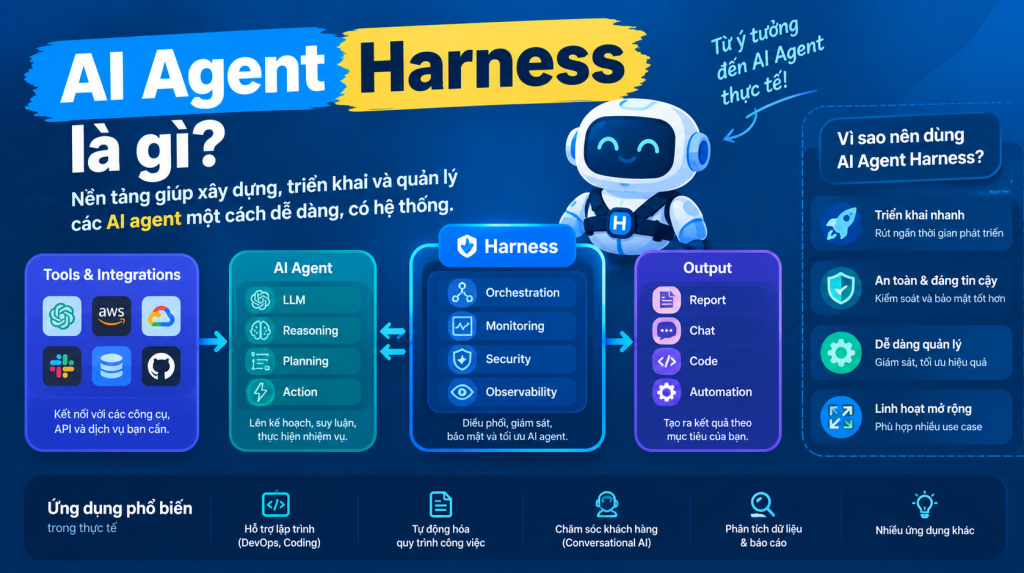
AI agent harness là gì?
Nói gọn, harness là toàn bộ phần mềm bao quanh một LLM để nó có thể hành động thay vì chỉ trả lời. Model suy luận và quyết định bước tiếp theo. Harness nối model với công cụ, bộ nhớ, môi trường thực thi và các hệ thống bên ngoài. Cả Databricks lẫn LangChain đều dùng chung một công thức: Agent = Model + Harness.
Vivek Trivedy của LangChain gói công thức này thành một câu dễ nhớ: nếu không phải model thì đó là harness. Còn Beren Millidge từng ví von từ năm 2023 rằng một LLM trần giống như CPU không có RAM, không ổ cứng, không cổng I/O. Chip xịn đến mấy mà không cắm gì vào thì cũng chỉ làm được việc sưởi ấm phòng.
| Thành phần | Vai trò | Ví von dễ nhớ |
|---|---|---|
| Model | Suy luận, dự đoán, sinh ra văn bản hoặc đầu ra khác | Bộ não |
| Harness | Thực thi hành động, quản lý bộ nhớ, chạy công cụ, áp dụng luật chơi | Cơ thể và bàn làm việc quanh bộ não |
| Agent | Hệ thống hoàn chỉnh kết hợp cả hai | Một nhân viên vừa biết nghĩ vừa biết làm |
Vì sao lại gọi là harness?
Cái tên này có một hành trình khá hay. Nó bắt đầu từ bộ yên cương của ngựa, đi sang test harness trong kỹ thuật phần mềm (lớp vỏ chạy code và tự động kiểm tra), rồi tới evaluation harness để cho model làm bài test, và cuối cùng là agent harness ngày nay. Hình ảnh con ngựa khỏe cần bộ yên cương tốt mới kéo được xe rất sát với bản chất: sức mạnh thì model đã có, nhưng muốn dùng nó vào việc cụ thể thì cần một bộ khung dẫn hướng.
Harness khác framework và orchestrator thế nào?
Ba khái niệm này hay bị trộn vào nhau, nên phân biệt luôn cho khỏi nhầm. Framework như LangChain, LangGraph hay smolagents cung cấp các viên gạch. Harness là thứ lắp các viên gạch đó thành một runtime có chủ kiến, với thiết lập mặc định hợp với bài toán của bạn. Orchestrator quyết định logic, ví dụ khi nào gọi model hay điều hướng ra sao, còn harness cấp những năng lực mà orchestrator cần: công cụ, bộ nhớ, môi trường chạy và kiểm soát quyền. Nói cách khác, cài xong một framework chưa có nghĩa là bạn đã có một harness tử tế.
Vòng lặp reason, act, observe: trái tim của mọi harness
Mở nắp một AI agent ra, bạn thường thấy một vòng lặp rất quen:
- Reason (suy luận): model đọc toàn bộ context gồm nhiệm vụ, bộ nhớ liên quan và kết quả trước đó, rồi quyết định làm gì tiếp theo.
- Act (hành động): harness thực thi quyết định đó, có thể là chạy một công cụ, chạy code trong sandbox, gọi API hoặc ghi dữ liệu.
- Observe (quan sát): harness thu kết quả và đưa ngược lại cho model dưới dạng context mới.
- Repeat (lặp lại): model dựa vào kết quả đó để chọn bước kế tiếp, cho đến khi việc xong.
Mô hình này gọi là ReAct, xuất phát từ bài báo ReAct: Synergizing Reasoning and Acting in Language Models của Shunyu Yao và cộng sự năm 2022. Hãy nghĩ tới một coding agent đang sửa bug. Model đề xuất một đoạn code, harness chạy nó trong môi trường cách ly, lấy kết quả test trả về. Test đỏ thì model gãi đầu nghĩ lại rồi thử tiếp. Giống hệt chúng ta lúc hai giờ sáng, chỉ khác là agent không cần cà phê.
Điều bất ngờ là bản thân vòng lặp này khá đơn giản. Theo một bài phân tích của Tian Pan, có những agent chỉ khoảng 100 dòng Python mà đạt 74 đến 76% trên SWE-bench Verified, chỉ kém các hệ thống hàng đầu vài điểm phần trăm. Phần khó nằm ở hạ tầng bao quanh vòng lặp, thứ mà các đội mạnh phải mất sáu đến mười hai tháng để xây.
Tám mảnh ghép của một harness chạy được ở production
Theo Databricks, hầu hết harness vận hành thực tế đều được dựng từ cùng một bộ thành phần nền tảng, mỗi thứ vá một điểm yếu của model thô.
1. System prompt: bản nội quy của agent
Đây là bộ chỉ dẫn cố định được đưa cho model mỗi lần chạy: bạn là ai, cần đạt gì, phải tuân thủ luật gì. Prompt viết ẩu là một trong những nguyên nhân phổ biến khiến agent lúc thế này lúc thế kia.
2. Công cụ (tools): đôi tay của model
Model chỉ quyết định dùng công cụ nào và khi nào. Harness mới là bên chạy công cụ thật và trả kết quả về. Xu hướng đáng chú ý là thay vì nhồi thật nhiều công cụ hẹp, nhiều đội cho agent khả năng viết và chạy code để tự dựng quy trình theo tình huống. Tian Pan có một phép thử khá hay: nếu kỹ sư người nhìn vào mà không nói được ngay nên dùng công cụ nào cho việc nào, thì agent cũng bó tay.
3. Sandbox: sân chơi có rào chắn
Sandbox là một không gian cách ly để agent chạy code mà không ảnh hưởng gì bên ngoài. Cho agent chạy code tự sinh thẳng lên hệ thống thật thì chẳng khác gì cho thực tập sinh gõ lệnh xóa trên server production. Có sandbox, bạn có thể theo dõi, reset hoặc tắt sạch khi có chuyện, và còn chạy được nhiều agent song song.
4. Filesystem: cuốn sổ tay không bao giờ mất
Filesystem cho agent nơi đọc và ghi file như code, ghi chú, kế hoạch, kết quả trung gian, và những thứ này tồn tại giữa các phiên làm việc. Nhờ vậy agent tích lũy được tiến độ cho việc dài hơi và cộng tác với người hay agent khác qua file chung, thay vì chỉ qua tin nhắn chat.
5. Bộ nhớ và quản lý context
LLM không nhớ gì ngoài cửa sổ context hiện tại. Harness phải quyết định cái gì giữ lại, cái gì tóm tắt, quá trình này gọi là context compaction. Giữa các phiên, harness lưu và truy xuất lịch sử liên quan để agent làm tiếp mà không bắt đầu lại từ số không.
6. Vòng phản hồi và tự kiểm tra
Harness tốt không chỉ để model làm mà còn kiểm tra việc nó làm: chạy test, soi kết quả, hoặc yêu cầu model rà lại đầu ra trước khi đi tiếp. Nhờ vậy agent mới xử lý được các tác vụ dài và phức tạp mà không tự tin tuyên bố xong khi còn dang dở.
7. Guardrails và human-in-the-loop
Guardrails là các luật cài sẵn trong harness để chặn hành động không an toàn hoặc chưa được duyệt, ví dụ phải có người đồng ý trước khi agent xóa file, nhắn khách hàng hay thanh toán. Trong môi trường doanh nghiệp, các chốt phê duyệt này thường là bắt buộc.
8. Observability: biết agent đã làm gì và vì sao
Log, trace và dashboard cho bạn thấy agent đã làm gì, quyết định ra sao, hỏng ở bước nào. Với dev đây là công cụ debug. Với doanh nghiệp, nhất là ngành bị quản lý chặt, đây là yêu cầu tuân thủ vì cần có dấu vết kiểm toán rõ ràng.
Cùng một model, khác harness: những con số đáng suy ngẫm
LangChain: từ ngoài top 30 lên top 5 mà không đụng đến model
Đội LangChain lấy coding agent deepagents-cli, giữ nguyên model GPT-5.2-Codex, chỉ chỉnh harness gồm system prompt, bộ công cụ và middleware. Điểm trên Terminal Bench 2.0, bộ benchmark có 89 tác vụ terminal sát thực tế, tăng từ 52,8% lên 66,5%, nhảy từ ngoài top 30 vào top 5. Mấy mẹo họ dùng nghe rất đời: bắt agent tự kiểm tra trước khi báo xong, nhắc giờ giấc vì agent nổi tiếng ước lượng thời gian rất tệ, và thêm một middleware phát hiện vòng lặp, hễ sửa đi sửa lại cùng một file quá nhiều lần là nhắc nó nghĩ lại cách tiếp cận.
Databricks: harness giúp nâng cấp model thành kết quả thật
Khi Databricks ghép GPT-5.5 với OfficeQA Pro Agent Harness, bộ khung thiết kế cho các tác vụ tài liệu doanh nghiệp nhiều phần, điểm đạt 52,63%, tăng từ 36,10% của GPT-5.4, tức là lỗi giảm gần một nửa. Công bằng mà nói, ở đây model cũng được nâng cấp nên không thể gán hết công cho harness. Điểm Databricks muốn nhấn mạnh là harness mới là thứ biến cải thiện của model thành hiệu năng ổn định ở production. Họ cũng cho rằng với nhiều tác vụ nặng quy trình, một harness mạnh quanh model tầm trung có thể thắng một harness yếu quanh model mạnh hơn.
OpenAI: một triệu dòng code, ba kỹ sư, và một bài học về môi trường
Tháng 2/2026, OpenAI công bố bài viết về harness engineering, kể lại thí nghiệm xây một sản phẩm bằng Codex. Commit đầu tiên vào repo trống diễn ra cuối tháng 8/2025. Sau đó, chỉ với ba kỹ sư điều khiển Codex, đội ngũ này đã tạo ra khoảng một triệu dòng code qua gần 1.500 pull request. Điều thú vị là giai đoạn đầu chậm hơn dự kiến, không phải vì Codex kém mà vì môi trường được mô tả chưa đủ: agent thiếu công cụ, thiếu cấu trúc và thiếu tài liệu để tiến tới mục tiêu lớn. Công việc chính của đội ngũ trở thành giúp agent làm việc được. Họ làm cho giao diện app, log và metrics đọc hiểu được với Codex, nối Chrome DevTools Protocol vào runtime để agent tự tái hiện bug và kiểm tra bản sửa, đồng thời đẩy phần lớn việc review sang cho các agent review lẫn nhau.
Anthropic: trí nhớ kiểu cá vàng và chuyện tách người làm khỏi người chấm
Với các tác vụ chạy nhiều giờ, mỗi cửa sổ context mới giống như một lần mất trí nhớ. Theo InfoQ, Anthropic xử lý bằng cách kết hợp reset context với các tài liệu bàn giao có cấu trúc để agent kế tiếp làm tiếp từ một trạng thái rõ ràng. Họ cũng nhận ra agent hay chấm bài của chính mình quá tay, nhất là với việc chủ quan như thiết kế giao diện, nên thêm một agent đánh giá riêng với tiêu chí chấm điểm cụ thể. Tách người làm khỏi người chấm hóa ra là đòn bẩy mạnh, giống như bạn không để dev tự duyệt pull request của chính mình.
Prompt, context và harness engineering: ba lớp của một củ hành
Cách làm việc với AI đã dịch chuyển dần ra phía ngoài: từ viết prompt hay hơn, sang kiểm soát thông tin model nhìn thấy, rồi tới thiết kế cả hệ thống quanh model. Prompt engineering và context engineering đều nằm bên trong harness engineering.
| Lớp | Tập trung vào | Sản phẩm chính | Thường gặp ở |
|---|---|---|---|
| Prompt engineering | Cách diễn đạt đầu vào để có câu trả lời tốt hơn | Một prompt được trau chuốt | Những ứng dụng LLM thời đầu |
| Context engineering | Chọn thông tin nào đưa cho model và khi nào | Pipeline truy xuất, thiết kế bộ nhớ | Các ứng dụng thời RAG |
| Harness engineering | Thiết kế toàn bộ hệ thống quanh model: công cụ, sandbox, vòng lặp, guardrails | Chính cái harness | Hệ thống agent và quy trình tự động |
Những cú vấp kinh điển khi xây harness
Theo Databricks, phần lớn lỗi của agent ở production đến từ harness chứ không phải từ model. Danh sách dưới đây chắc chắn sẽ khiến bạn gật gù vì quen quen:
- Context rot: lịch sử hội thoại càng dài, chất lượng suy luận càng tụt. Không cắt tỉa hay tóm tắt thì agent làm việc dài là xuống phong độ.
- Tool overload: đưa quá nhiều công cụ một lúc khiến model rối, giống như bạn mở một hộp đồ nghề 200 món rồi quên mất mình định đóng cái đinh.
- Brittle tool wiring: đổi nhẹ cách mô tả hoặc cách gọi công cụ là model dùng sai, và lỗi âm thầm rất khó dò.
- Latency: agent nhiều bước gọi nhiều công cụ có thể mất hơn 10 giây mới trả lời, trải nghiệm người dùng không dễ chịu chút nào.
- Irrelevant retrieval: harness lôi nhầm thông tin từ bộ nhớ hoặc công cụ tìm kiếm, và model tự tin trả lời sai một cách rất thuyết phục.
- Weak verification: không có vòng kiểm tra thì agent dễ dừng sớm hoặc tuyên bố hoàn thành khi việc mới xong một nửa.
- Missing guardrails: agent thực hiện hành động không thể hoàn tác như gửi tin, xóa dữ liệu hay mua hàng mà không ai duyệt.
Thêm một ca nữa mà đội LangChain gọi là doom loop: agent kẹt trong việc lặp đi lặp lại đúng một cách làm đã thất bại. Cách họ xử lý là một lớp middleware phát hiện mẫu lặp và ngắt vòng, giống như bạn khẽ nhắc đồng nghiệp rằng restart lần thứ mười chưa chắc đã khác lần thứ chín.
Harness nên dày hay mỏng, và vì sao nó có hạn sử dụng
Có một bài học khá thấm từ chính Anthropic. Họ nhận xét rằng harness luôn mang theo những giả định về việc model chưa tự làm được. Chẳng hạn một harness từng cần reset context để chữa cho Claude khỏi hành vi vội vã khi context đầy, nhưng khi chạy cùng harness đó trên Claude Opus 4.5 thì hành vi kia biến mất, và các bước reset trở thành gánh nặng vô ích. Bài học cho dev là định kỳ rà lại harness, vì có những thứ bạn dựng để vá điểm yếu của model cũ sẽ thành đồ thừa khi model mới ra.
Databricks cũng cùng quan điểm. Khi model giỏi lập kế hoạch, suy luận nhiều bước và sửa lỗi hơn, một số việc harness đang gánh sẽ dịch dần vào trong model. Nhưng môi trường thực thi, điều phối công cụ, guardrails, observability và vòng phản hồi thì vẫn cần. Hai hướng đi đang nổi lên là disposable harness, tức harness gọn nhẹ dựng cho một quy trình rồi bỏ, và natural-language agent harness, nơi kỹ sư mô tả hành vi agent bằng ngôn ngữ tự nhiên rồi một runtime chung diễn giải và thực thi.
Một ví dụ cho thấy harness là thứ phải liên tục mài giũa: theo Tian Pan, Manus đã viết lại harness của mình năm lần trong sáu tháng với cùng các model nền, và lần nào độ ổn định cũng cải thiện.
Khi cả công ty cùng làm agent: bài toán agent sprawl
Ở quy mô doanh nghiệp, hiếm ai chỉ xây một agent. Mỗi team một agent, mỗi agent một model, mỗi cái một kiểu harness, và rồi không ai quản nổi. Databricks gọi hiện tượng này là agent sprawl. Giải pháp họ đưa ra là một lớp hạ tầng harness dùng chung để xây, triển khai, quản trị và đánh giá agent, với Agent Bricks làm nền tảng, Unity Catalog lo quản trị và MLflow lo quan sát, đánh giá. Đây là hướng đi của một nhà cung cấp cụ thể nên bạn có thể có lựa chọn khác, nhưng nguyên tắc thì chung: kiểm soát quyền truy cập, kiểm toán được, đánh giá liên tục và dễ đổi model mà không phải xây lại toàn bộ hệ thống.
Là dev, bạn nên bắt đầu từ đâu?
Tin vui là bạn không cần một dàn hạ tầng khổng lồ để bắt đầu. Dưới đây là lộ trình gọn dựa trên những gì các đội trên chia sẻ:
- Bắt đầu thật nhỏ. Một file ghi tiến độ, một danh sách việc có đánh dấu xong hay chưa, và quy ước mỗi phiên chỉ làm một đơn vị việc. Nhiều kỹ sư mô tả đây chính là cốt lõi của thiết kế harness cho agent chạy dài mà Anthropic chia sẻ.
- Biến repo thành nơi agent đọc hiểu được. Một file kiểu AGENTS.md chỉ đường, tài liệu kiến trúc rõ ràng, log và metrics truy cập được, đúng tinh thần OpenAI.
- Cho agent cách tự kiểm tra. Test, linter, chạy thử giao diện. Đừng để agent là người duy nhất tin rằng việc đã xong.
- Giữ bộ công cụ gọn. Ít công cụ nhưng được chọn kỹ thường tốt hơn một danh mục đồ sộ.
- Ghi lại trace và đọc nó. LangChain dựa vào trace để tìm kiểu lỗi lặp đi lặp lại rồi chỉnh harness đúng chỗ.
- Đặt chốt chặn cho hành động không thể hoàn tác. Xóa, gửi, thanh toán đều nên có bước duyệt.
- Đo bằng bộ đánh giá của riêng bạn. Benchmark công khai chỉ là thước đo gần đúng, thứ quan trọng là agent có làm đúng việc trên dữ liệu và quy trình của bạn không.
Câu hỏi thường gặp
AI agent khác gì AI harness?
Agent là hệ thống hoàn chỉnh gồm model và harness. Harness là lớp thực thi cung cấp công cụ, bộ nhớ, guardrails và điều khiển quy trình. Bạn trò chuyện với agent, nhưng harness mới là thứ giúp nó làm được việc.
Harness engineering khác prompt engineering ở điểm nào?
Prompt engineering chăm chút đầu vào cho model. Harness engineering thiết kế toàn bộ hệ thống quanh model, gồm công cụ, môi trường chạy, cơ chế an toàn và vòng phản hồi. Prompt chỉ là một phần của harness.
Harness có thật sự quan trọng hơn model không?
Không nên đặt hai thứ lên bàn cân theo kiểu thắng thua. Nhưng khi các model ngày càng gần nhau về năng lực thô, chất lượng harness ngày càng quyết định hiệu quả thực tế. Nâng cấp model mà hạ tầng xung quanh vẫn lỏng lẻo thì mức cải thiện thường nhỏ hơn bạn kỳ vọng.
Trước khi đổi model lần nữa, hãy xem lại bộ yên cương
Lần tới khi agent của bạn làm ăn lủng củng, phản xạ đầu tiên có lẽ là nghĩ tới chuyện đổi sang model mới hơn, đắt hơn. Hãy khoan. Kiểm tra xem context có đang phình ra không, công cụ có quá nhiều không, agent có cách tự kiểm tra kết quả chưa và có ai đọc log lần nào chưa. Con ngựa tốt đến mấy mà yên cương lỏng lẻo thì xe vẫn chạy vẹo. Còn nếu bộ yên cương chắc chắn, bạn sẽ thấy ngay cả model tầm trung cũng kéo được một chuyến hàng đáng nể.
Nguồn tham khảo
- Databricks, What is an AI Agent Harness? databricks.com/blog/ai-harness
- OpenAI, Harness engineering: leveraging Codex in an agent-first world openai.com/index/harness-engineering
- Anthropic Engineering, Scaling Managed Agents: Decoupling the brain from the hands anthropic.com/engineering/managed-agents
- InfoQ, Anthropic Designs Three-Agent Harness Supports Long-Running Full-Stack AI Development infoq.com
- LangChain, Improving Deep Agents with harness engineering (Vivek Trivedy) blog.langchain.com
- Daily Dose of Data Science, The Anatomy of an Agent Harness dailydoseofds.com
- Tian Pan, The Anatomy of an Agent Harness tianpan.co
- Yuval Avidani, Agent Harness from 0 to 100 yuv.ai
- Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models arxiv.org/abs/2210.03629
- Merrill et al., Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces (ICLR 2026) proceedings.iclr.cc
- Mejba Ahmed, Anthropic's Agent Harness Design Changed How I Think mejba.me
0 Bình luận